10 min de lectura
Gestión de incidentes: etapas, prioridades y roles
Qué es la gestión de incidentes, sus etapas según ITIL, cómo priorizar por impacto y urgencia, qué roles asignar y cómo cerrar con una revisión útil.
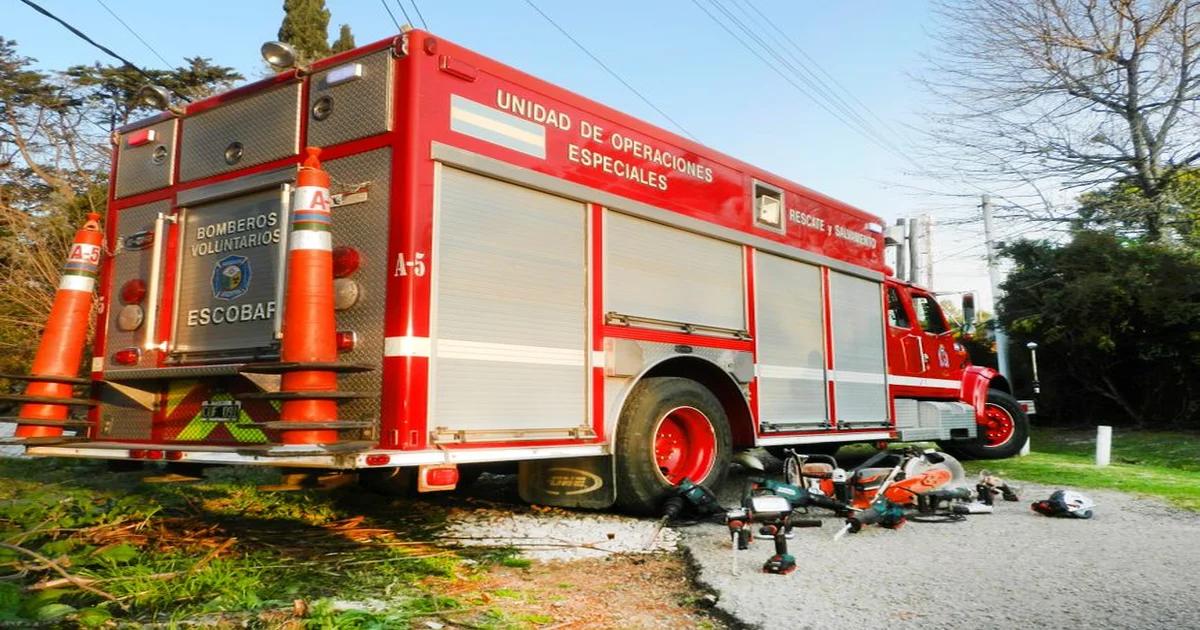
Cuando algo falla en la operación y no hay un proceso acordado, cada persona reacciona a su manera. Uno llama al jefe, otro abre un chat grupal, alguien más intenta arreglarlo solo. Se pierde tiempo, la información queda repartida en tres conversaciones y una falla que podía restaurarse en 20 minutos termina ocupando la mañana entera.
La gestión de incidentes existe para ordenar ese momento. Convierte "algo salió mal" en una respuesta coordinada, registrada y de la que el equipo puede aprender.
Qué es la gestión de incidentes
Un incidente es una interrupción no planificada de un servicio o proceso, o una baja en su calidad. Puede ser la caída de un sistema, un camión varado con un pedido urgente, una conciliación bancaria que no cuadra el día del cierre o una queja crítica de un cliente grande.
La gestión de incidentes es el conjunto de pasos para detectar ese evento, registrarlo, priorizarlo y restaurar la operación lo antes posible. El nombre viene de ITIL, el marco de gestión de servicios de TI, que la trata como una de sus prácticas. Su lógica sirve en cualquier área que dependa de un flujo de trabajo.
ITIL separa dos tareas que en el día a día se mezclan:
- Gestión de incidentes: restaurar el servicio cuanto antes, aunque sea con una solución provisional.
- Gestión de problemas: encontrar la causa raíz de uno o varios incidentes y eliminarla para que no vuelvan.
Tener las dos separadas evita una tensión conocida: con el servicio caído, investigar causas retrasa la restauración; con el servicio restaurado, nadie quiere investigar. Cada tarea necesita su propio dueño y su propio momento.
Una aclaración de vocabulario: en seguridad laboral, "incidente" suele nombrar un evento que pudo causar lesiones y no las causó. Si el evento es un accidente de trabajo, los plazos y formatos de notificación los fija la normativa de cada país, y este proceso los complementa sin reemplazarlos.
Por qué le importa al gerente
Muchos gerentes dan por hecho que los incidentes son asunto de TI o de seguridad industrial. Cualquier área tiene incidentes: ventas pierde acceso al CRM el último día del mes, logística tiene un despacho detenido, finanzas tiene un pago a proveedores rechazado por el banco.
Sin un proceso claro, el gerente termina siendo el único punto de coordinación. Todo pasa por su teléfono y todo espera su decisión, lo que vuelve la respuesta lenta y deja al equipo dependiendo de una sola persona. Es el mismo patrón que describe el pilar sobre productividad del equipo sin heroísmo.
Con un proceso definido, el equipo sabe qué hacer en los primeros minutos, quién decide, a quién avisar y cuándo escalar. El gerente pasa de apagar cada fuego a cuidar que el proceso funcione.
Las etapas del proceso
ITIL describe la práctica con pasos que cada organización agrupa a su manera. Esta versión en cinco etapas cubre lo esencial:
| Etapa | Qué ocurre | Quién la lleva | Qué deja |
|---|---|---|---|
| 1. Detección | Una alerta, un operador o un cliente avisa que algo falla | Quien lo nota | El aviso al canal acordado |
| 2. Registro | Se anota qué pasó, cuándo, dónde y quién lo detectó | Quien recibe el aviso | Un registro con número y hora |
| 3. Clasificación y prioridad | Se define el tipo de incidente y su prioridad según impacto y urgencia | Quien coordina | Prioridad asignada y, si corresponde, escalamiento |
| 4. Resolución | Se restaura el servicio, con solución provisional o definitiva | El equipo técnico o de operación | Servicio restaurado y lo que se hizo para lograrlo |
| 5. Cierre y revisión | Se confirma con el afectado que todo funciona y, en los incidentes graves, se hace una revisión posterior | Quien coordina | Cierre formal y acciones con dueño y fecha |
Algunos detalles de cada etapa que suelen fallar:
Detección. Mientras antes se detecta, menor es el daño. Los equipos que aprenden a leer señales tempranas, como un atraso pequeño que se repite o un arreglo improvisado que alguien aplica todas las semanas, actúan antes de que el problema crezca.
Registro. Es el paso que más se salta cuando hay apuro. Sin registro desaparece la trazabilidad, se pierde la base para encontrar patrones y queda imposible demostrar los tiempos de respuesta comprometidos en un acuerdo de nivel de servicio. Basta con que el registro se abra en el momento; los detalles se completan después.
Clasificación y prioridad. La prioridad sale de cruzar dos preguntas: a cuántas personas o procesos afecta (impacto) y qué tan rápido crece el daño si nadie actúa (urgencia). Una falla que detiene la producción tiene impacto alto; una que demora un informe interno de la próxima semana tiene urgencia baja. Cuando la prioridad supera lo que el primer nivel puede resolver, se escala según reglas escritas de antemano, como en una matriz de escalamiento.
Resolución. Conviene distinguir la solución provisional, que restaura la operación, de la solución definitiva, que elimina la causa. En un incidente lo primero es restaurar. El riesgo aparece después: se aplica el parche, se cierra el registro y la causa queda intacta.
Cierre y revisión. El incidente se cierra cuando el afectado confirma que el servicio funciona. Los incidentes graves y los que se repiten pasan además a una revisión posterior, conocida en la industria del software como postmortem.
La matriz de prioridad: impacto y urgencia
Para priorizar sin discutir en plena crisis, sirve tener una matriz acordada antes. Esta versión de dos por dos es fácil de recordar:
| Impacto / urgencia | Urgencia alta | Urgencia baja |
|---|---|---|
| Impacto alto | Prioridad 1: respuesta inmediata | Prioridad 2: atención dentro del turno |
| Impacto bajo | Prioridad 3: atención programada | Prioridad 4: registrar y revisar |
La prioridad 1 activa al equipo de respuesta y al gerente. La prioridad 4 se acumula para la revisión semanal. Si el volumen de casos es alto, una matriz de tres por tres da más matices; en el artículo sobre mesa de ayuda hay un ejemplo con niveles de soporte.
Dos reglas hacen que la matriz funcione. La primera, que cada celda tenga un tiempo de respuesta escrito (por ejemplo, 15 minutos para la prioridad 1 y un día hábil para la 3). La segunda, que cualquiera del equipo pueda subir la prioridad si ve que el daño crece, sin pedir permiso.
Roles durante un incidente grave
En un incidente de prioridad 1 hay tres trabajos que compiten por la misma persona si nadie los reparte: coordinar, resolver y comunicar. La práctica de gestión de incidentes que describe Google en Site Reliability Engineering (Beyer y otros, 2016), basada en el Sistema de Comando de Incidentes que usan los servicios de emergencia, los separa:
| Rol | Qué hace |
|---|---|
| Coordinador del incidente | Asigna tareas, decide prioridades y lleva la línea de tiempo |
| Equipo de resolución | Diagnostica y restaura el servicio |
| Responsable de comunicación | Informa a afectados y a la dirección en intervalos fijos |
En un equipo pequeño, una misma persona puede tener dos roles. Lo que conviene evitar es que quien está resolviendo tenga que contestar cada cinco minutos cómo va la cosa.
Cómo comunicar mientras dura el incidente
Las personas afectadas necesitan tres datos: qué pasó, qué se está haciendo y cuándo habrá novedades. Cuando no los reciben por un canal oficial, completan el vacío con rumores, y el rumor suele sonar peor que la realidad.
El responsable de comunicación informa en intervalos regulares, por ejemplo cada 30 minutos en un incidente de prioridad 1, aunque la novedad sea "seguimos trabajando y el próximo aviso es a las 11:00". Un aviso puntual con poca información genera más confianza que un silencio largo.
Si el incidente cruza varias áreas, ayuda tener definidos de antemano los acuerdos entre áreas y su seguimiento, y saber quiénes son las partes interesadas que deben enterarse primero.
Un ejemplo con tiempos
Un martes, el sistema de facturación deja de emitir documentos.
| Hora | Hecho |
|---|---|
| 8:40 | El sistema falla (se sabrá después, al revisar los registros) |
| 9:10 | Un vendedor avisa que no puede facturar |
| 9:15 | Se abre el registro; prioridad 1 por impacto alto y urgencia alta |
| 9:55 | Se restaura el servicio liberando espacio en el disco lleno y reiniciando el proceso de envío (solución provisional) |
| Miércoles | Se aplica la solución definitiva: limpieza automática de archivos temporales y alerta cuando el disco pasa del 80 % |
Con esos datos:
- Tiempo hasta detectar: de 8:40 a 9:10, 30 minutos.
- Tiempo de restauración desde el aviso: de 9:10 a 9:55, 45 minutos.
- Duración total de la interrupción: de 8:40 a 9:55, 75 minutos.
Los 30 minutos de detección pesan 40 % de la interrupción (30 / 75). Ahí está la mejora más barata: una alerta automática cuando el sistema deja de emitir.
Si en el mes hubo cuatro incidentes de prioridad 1 con 75, 40, 120 y 65 minutos de interrupción, el tiempo medio es 300 / 4 = 75 minutos. Es una de las lecturas del indicador MTTR; conviene dejar escrito desde qué momento y hasta cuál se mide, porque cada definición da una cifra distinta. Lo mismo aplica al tiempo de respuesta.
El error más común: confundir restauración con solución
Cuando el sistema vuelve a funcionar, baja la presión y el equipo pasa al siguiente tema. El registro queda a medias, la revisión nunca ocurre y el mismo incidente regresa semanas después, porque se trató el síntoma.
Para evitarlo, el cierre de un incidente grave debe dejar dos cosas: la confirmación de que el servicio fue restaurado y al menos una acción correctiva con dueño y fecha. Puede ser un cambio de proceso, una alerta nueva o una capacitación puntual.
La revisión posterior funciona mejor sin buscar culpables. Si la gente teme que el informe la señale, reporta menos y más tarde, y los incidentes se detectan peor. La pregunta útil es qué permitió que la falla ocurriera y qué la habría detectado antes. Para incidentes que se repiten o afectan a un cliente, la metodología 8D ordena la investigación en pasos, y lo aprendido vale la pena guardarlo como lecciones aprendidas que otros equipos puedan consultar.
Cuando la falla es tan grande que deja fuera procesos críticos por horas o días, el tema pasa a continuidad del negocio.
Cómo empezar si tu equipo todavía no tiene un proceso
Para arrancar alcanzan tres decisiones concretas:
- Define qué es un incidente en tu área. Acuerda con el equipo qué eventos activan el proceso. Sin esa definición, cada persona decide sola si algo merece reportarse.
- Crea un registro mínimo. Un formulario simple o una hoja compartida con fecha, hora, descripción, impacto, prioridad, responsable y estado.
- Fija una revisión periódica. Una vez por semana o por mes, revisa los incidentes cerrados y busca patrones. Un mismo problema que aparece tres veces en un mes merece su propio análisis de causa.
Con esa base, el proceso crece a medida que el equipo lo usa: primero la matriz de prioridad, después los roles para los incidentes graves y, más adelante, los tiempos comprometidos por prioridad.
Sigue leyendo
Artículo
Acuerdos entre áreas: cómo hacer que se cumplan
Cómo cerrar acuerdos entre áreas con dueño único, registro en 24 horas, punto medio y cierre formal, para dejar de perseguir a quien no te reporta.
Artículo
AMFE: qué es y cómo aplicarlo paso a paso
El AMFE anticipa fallas antes de que ocurran. Aprende qué es, cómo se construye y cómo aplicarlo en tu equipo con un ejemplo concreto.
Artículo
Análisis seguro de trabajo (AST): pasos, ejemplo y errores
Qué es el análisis seguro de trabajo, sus cuatro pasos, un ejemplo resuelto con jerarquía de controles y qué le toca al gerente para que se use de verdad.
Artículo
Apetito de riesgo: qué es y cómo definirlo
Conoce qué es el apetito de riesgo, cómo convertirlo en límites claros y qué decisiones ayuda a tomar cuando una oportunidad exige exposición.
¿Quieres un paso siguiente concreto?
Si buscas algo más profundo: Comunidad de Gestión y Liderazgo →
Newsletter editorial
Una vez por semana, una idea aplicable sobre gestión, liderazgo o carrera. Directo al inbox, sin ruido.
Sin spam. Te puedes dar de baja cuando quieras.